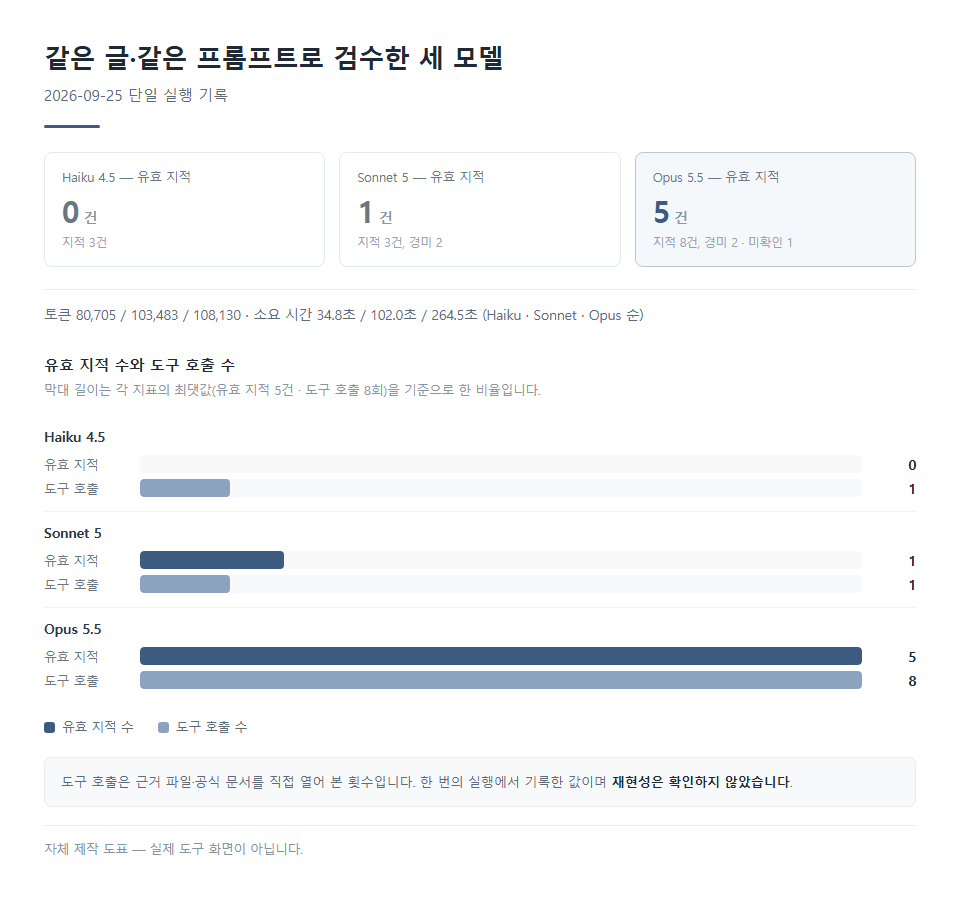
같은 글 한 편을 세 모델에 검수시켰더니, 실제로 쓸모 있었던 지적이 0건, 1건, 5건으로 갈렸습니다. 맡긴 모델은 순서대로 Haiku 4.5, Sonnet 5, Opus 5.5였고, 검수 대상은 제가 이미 발행해 둔 글이었습니다. AI 검수 결과를 그대로 반영하기 전에 무엇을 먼저 확인해야 하는지, 아래 실행 기록이 그 기준을 보여 줄 것입니다. 결론부터 적자면 결과와 함께 움직인 것은 1차 자료를 직접 열어 확인했는지였습니다. 다만 한 번의 관찰이라 모델 크기의 영향과 분리되지는 않습니다. 유효하다고 판정한 지적 때문에 그 글의 제목과 본문 다섯 곳, 요약문을 실제로 고쳤습니다(주소는 그대로 두었습니다). 미리 밝혀 두자면 이것은 2026년 9월 25일에 한 번 실행한 관찰이며, 모델 순위를 매기려는 글이 아닙니다.
이미 발행한 제 글을 검수 대상으로 삼았습니다
검수 결과를 비교하려면 지적 하나하나가 맞는지 제가 직접 가를 수 있어야 합니다. 남이 쓴 글을 대상으로 삼으면 모델이 어떤 수치를 틀렸다고 지적했을 때 그 말이 옳은지 확인할 방법이 없습니다. 그러면 건수만 세게 되고, 건수는 검수 품질과 다릅니다. 유효와 무효를 나누려면 정답을 쥔 사람이 채점해야 합니다.
그래서 같은 날 발행한 제 글을 대상으로 골랐습니다. 색인 점검 경고 27건, 원인은 제 비교 코드였습니다라는 글로, 점검 스크립트가 낸 경고 27건이 실제로는 오탐이었다는 기록입니다. 이 글은 제가 자료 수집부터 확인까지 전부 했기 때문에, 근거가 된 원본 기록이 그대로 남아 있습니다. 모델이 사실관계 오류를 지적하면 원본을 열어 대조하면 되고, 논리 오류를 지적하면 제가 어떤 판단으로 그 문장을 썼는지 되짚을 수 있습니다. 채점이 가능한 답안지를 고른 셈입니다.
조건을 똑같이 맞췄습니다
세 번의 실행에서 바꾼 것은 모델 이름 하나뿐입니다.
프롬프트는 글자 하나까지 동일하게 입력했습니다. 요구한 항목은 사실관계 오류, 논리 오류, 자기모순, 독자를 잘못 이끌 위험, 이 네 가지였습니다. 각 지적에는 근거를 반드시 붙이게 했고, 확실하지 않으면 “미확인”으로 표기하도록 했습니다. 칭찬과 요약은 금지했습니다. 잘 쓴 부분을 나열하는 답변이 섞이면 분량만 늘고 정작 지적이 묻히기 때문입니다.
대상 파일도 같은 파일 하나였고, 보고 형식도 위치·유형·문제·근거 네 칸으로 통일했습니다. 형식이 다르면 어느 쪽 지적이 더 구체적인지 비교할 수 없습니다. 작업 시간은 10분으로 제한했고, 세 모델 모두 같은 구독 안에서 실행했습니다.
건수만 보면 두 모델이 동률이었습니다. 그런데 원본 자료로 하나씩 대조한 뒤 남은 유효 지적은 전혀 달랐고, 그 간극이 이 글의 본론입니다.
세 모델의 결과
같은 원고와 같은 검수 지시문을 Haiku 4.5, Sonnet 5, Opus 5.5에 각각 한 번씩 전달하고 2026-09-25에 측정한 기록입니다.
| 모델 | 지적 건수 | 유효 | 경미 유효 | 무효·미확인 | 사용 토큰 | 소요 시간(초) | 도구 호출 |
|---|---|---|---|---|---|---|---|
| Haiku 4.5 | 3 | 0 | 0 | 3 | 80,705 | 34.8 | 1 |
| Sonnet 5 | 3 | 1 | 2 | 0 | 103,483 | 102.0 | 1 |
| Opus 5.5 | 8 | 5 | 2 | 1 | 108,130 | 264.5 | 8 |
건수는 겹치는데 유효 판정은 갈렸습니다. 대신 Opus 5.5는 Haiku 4.5보다 시간을 7.6배, 토큰을 1.3배 더 썼습니다. 유효 5건은 그 대가로 얻은 결과입니다.
Opus 5.5가 짚은 유효 5건은 다음과 같습니다.
- 제목이 원인을 ‘한글 주소’로 귀인해, 독자가 주소를 영문으로 바꿀 위험이 있습니다
- “서치콘솔이 낸 경고”로 읽히지만 실제로는 제 스크립트가 낸 경고입니다
- 빈 값 예외 처리를 이번 수정으로 넣은 것처럼 서술했습니다
- “대표 주소가 어긋나면 색인에서 밀려난다”는 틀린 설명을 정정 없이 남겼습니다
- 서치콘솔 수작업 부담을 과장했습니다. 색인 여부 자체는 보고서에서 목록으로 확인됩니다
Sonnet 5의 유효 1건은 4번과 같은 지점이었습니다. 두 모델이 겹쳐서 짚은 곳은 여기 한 군데뿐이었습니다.
갈린 지점은 파일을 열었는지였습니다
도구 호출 수를 보면 Opus 5.5만 8회이고 나머지 둘은 1회씩입니다. 유효 건수와 이 숫자가 같은 방향으로 움직였습니다.
실행 기록에 남은 도구 호출은 Opus 5.5만 8회였고 나머지 두 모델은 1회였습니다. 위 3번 지적을 제가 검증할 때는 점검 스크립트와 측정 JSON을 열어 대조했습니다. 구글이 아직 모르는 주소 6건 중 한글 주소 4건이 수정 전에도 경고 없이 통과한 기록이 남아 있었고, 9월 12일자 스크립트 백업본에도 같은 예외 처리가 들어 있어, 이번 수정으로 추가한 것이 아님을 확인했습니다. 나머지 두 모델은 원고만 읽고 판단했습니다.
다만 Haiku 4.5와 Sonnet 5는 도구 호출이 똑같이 1회인데도 유효 0건과 1건으로 갈렸습니다. 1차 자료를 열었는지가 전부를 설명하지는 않습니다. 단일 실행 관찰이며, 같은 작업을 다시 실행해도 같은 결과가 나온다는 보장은 없습니다.
틀린 지적도 나왔습니다
Haiku 4.5의 3건 중 제가 유효로 판정한 것은 없었습니다.
이 중 한 건은 구글 Indexing API가 채용공고와 라이브 스트리밍 말고도 뉴스, 구조화 데이터, 모바일 앱을 지원한다는 지적이었습니다. 구글 공식 문서는 “The Indexing API can only be used to crawl pages with either JobPosting or BroadcastEvent embedded in a VideoObject”라고 적고 있습니다. 채용공고와 동영상에 포함된 라이브 방송, 두 가지뿐입니다.
검수 결과를 확인 없이 그대로 반영했다면, 맞게 쓴 문장을 틀리게 고칠 뻔했습니다. 나머지 2건은 근거로 든 것이 원고가 이미 제시한 실측값과 어긋나 반영하지 않았습니다. 유효·무효 판정은 제가 내린 것이고, 개별 판정 근거를 따로 남긴 것은 이 한 건입니다.
검수를 맡길 때 제가 바꾼 것
이번 결과를 확인한 뒤 제 검수 절차에서 세 가지를 바꿨습니다.
첫째, 검수 프롬프트에 “근거 파일을 직접 열어 확인하라”를 명시합니다. 원고만 읽고 답한 쪽과 근거를 실제로 열어 본 쪽의 결과가 갈렸기 때문에, 이제는 “확인하라”가 아니라 “파일을 열어서 대조한 뒤 어떤 파일의 어느 부분을 봤는지 적으라”까지 요구합니다. 근거를 적게 하면 열지 않고 답한 경우가 눈에 보입니다.
둘째, 지적을 그대로 반영하지 않고 제가 1차 자료로 유효·무효를 먼저 판정합니다. 앞의 Indexing API 사례처럼, 그대로 반영했다면 맞는 문장을 틀리게 고쳤을 지적이 실제로 있었습니다. 검수 결과는 수정 지시가 아니라 확인 목록으로 취급하는 편이 안전했습니다. AI 7명에게 글 한 편 맡겼더니 토큰 74만 개에 적었듯 검수에 드는 몫이 초안보다 큰데, 이번 기록은 그 몫을 어디에 써야 하는지도 같이 보여 줬습니다.
셋째, “미확인”으로 표시된 항목은 따로 확인하거나 반영하지 않습니다. 이번 검수 프롬프트에는 “확실하지 않으면 미확인으로 표시하고 추측을 사실로 쓰지 말 것”을 넣어 두었습니다. 미확인 표시는 판정이 끝나지 않았다는 뜻이므로, 제가 1차 자료로 직접 확인해 결론을 내리거나 보류합니다. 애매한 항목을 일단 고치고 보는 습관이 가장 위험했습니다.
이 실험이 말해 주지 않는 것
이 관찰로 말할 수 있는 범위는 생각보다 좁습니다. 아래 네 가지는 이 결과가 보증하지 않습니다.
- 재현성 — 2026-09-25 단일 실행 1회를 본 것입니다. 같은 프롬프트로 다시 실행하면 건수와 도구 호출 횟수가 달라질 수 있습니다.
- 다른 작업으로의 확장 — 확인한 것은 사실·논리 검수 한 종류뿐입니다. 요약, 번역, 코드 작성 능력과는 관계가 없습니다.
- 주제 의존성 — 대상이 제가 쓴 글 한 편입니다. 주제와 근거 자료의 형태가 바뀌면 결과도 달라질 수 있습니다.
- 판정 기준 — 유효와 무효를 가른 사람은 저입니다. 제 판단이 기준이었다는 점을 빼고 이 숫자를 읽으면 안 됩니다.
따라서 이 글의 0건, 1건, 5건은 모델의 순위표가 아니라 제 작업 절차를 바꾼 계기로 읽어 주시기 바랍니다.
정리
스킬 60개 삭제해도 0.1k, 클로드코드 토큰 실측 6가지를 쓸 때도 그랬지만, 숫자는 확인한 사람이 책임집니다. 검수 결과를 받으면 지적 목록보다 근거를 먼저 여십시오. 해당 문장이 참조한 원문을 직접 확인하는 데 드는 시간이 잘못 고친 문장을 되돌리는 시간보다 짧습니다.
그리고 검수 과정에서 도구 호출이 0~1회에 그쳤다면, 그 결과는 원고만 읽고 낸 판단일 수 있습니다. 검수를 맡길 때 근거 확인 여부를 함께 적게 하면 이 구분이 바로 드러납니다.