블로그 글 한 편을 만드는 데 AI 에이전트 7명을 투입했고, 토큰(AI가 읽고 쓴 텍스트 양을 세는 단위) 738,907개를 사용했습니다. 그런데 그날 추가로 청구된 금액은 0원이었습니다. 정액 구독 하나로 어디까지 맡길 수 있는지 계산해 보신 적이 있다면, 제가 2026년 9월 24일 하루 동안 실제로 기록한 사용량이 그 판단 기준이 됩니다.
혼자 쓰지 않고 7명에게 나눴습니다
2026년 9월 24일 서치콘솔 색인 경고 27건, 원인은 한글 주소였습니다를 만들 때는 역할을 나눠 순차와 병렬을 섞어 진행했습니다.
- 초안 작가 3명(병렬) — 도입·배경, 사용법, 비교·결론으로 섹션을 나눠 동시에 집필
- 통합(제가 직접) — 세 원고의 어조와 연결부를 맞춰 한 편으로 합침
- 팩트체커 1명 — 본문의 수치·고유명사를 원본 자료와 대조
- 편집장 1명 — 제목 후보 선택, 어조와 분량 기준 점검
- 콘텐츠 리뷰어 1명 — 흐름, 중복, 남아 있는 AI 티 제거
- 이미지 목업 제작 1명 — 본문에 넣을 화면 재현 이미지(HTML 목업) 제작
나눈 이유는 시간과 검수의 독립성입니다. 작가 3명을 병렬로 실행하면 세 섹션의 결과가 한 번에 도착하고, 검수를 작성자와 분리해야 초안에서 놓친 문장이 걸러집니다. 두 가지 모두 뒤에서 실제 수치와 함께 다루겠습니다.
토큰을 세어 본 이유
정액 구독은 작업을 아무리 많이 실행해도 청구서에 금액이 새로 추가되지 않습니다. 이번 에이전트 7명은 Claude 정액 구독 안에서 실행했고 건당 추가 과금은 없었습니다. 인물·분위기 이미지 생성만 ChatGPT 구독으로 따로 실행했기 때문에 아래 토큰 합계에는 포함되지 않습니다. 표의 “이미지 목업 제작”은 HTML로 화면을 재현하는 작업이라 Claude 구독 안에서 실행했고 합계에 들어 있습니다.
그런데 구독에는 사용 한도가 있습니다(Claude Code 사용량·비용 안내). 결제 금액이 늘지 않을 뿐, 사용량이 많으면 한도에 먼저 닿습니다. 이 구조에서는 계산해야 할 값이 바뀝니다. 지출이 아니라 한도 구간 안에 남은 작업량이 관심사가 됩니다. 그래서 감으로 “오늘 많이 사용했다”라고 넘기는 대신, 에이전트별로 토큰을 적어 두고 합계를 확인하기 시작했습니다.
7명이 쓴 토큰을 전부 세어 봤습니다
| 역할 | 사용 토큰 | 실행 시간(초) | 도구 호출 |
|---|---|---|---|
| 초안 작가 a | 86,948 | 214 | 5 |
| 초안 작가 b | 81,079 | 201 | 8 |
| 초안 작가 c | 112,854 | 311 | 18 |
| 팩트체커 | 130,840 | 349 | 24 |
| 편집장 | 106,163 | 236 | 11 |
| 콘텐츠 리뷰어 | 101,949 | 182 | 4 |
| 이미지 목업 제작 | 119,074 | 253 | 18 |
| 합계 | 738,907 | — | 88 |
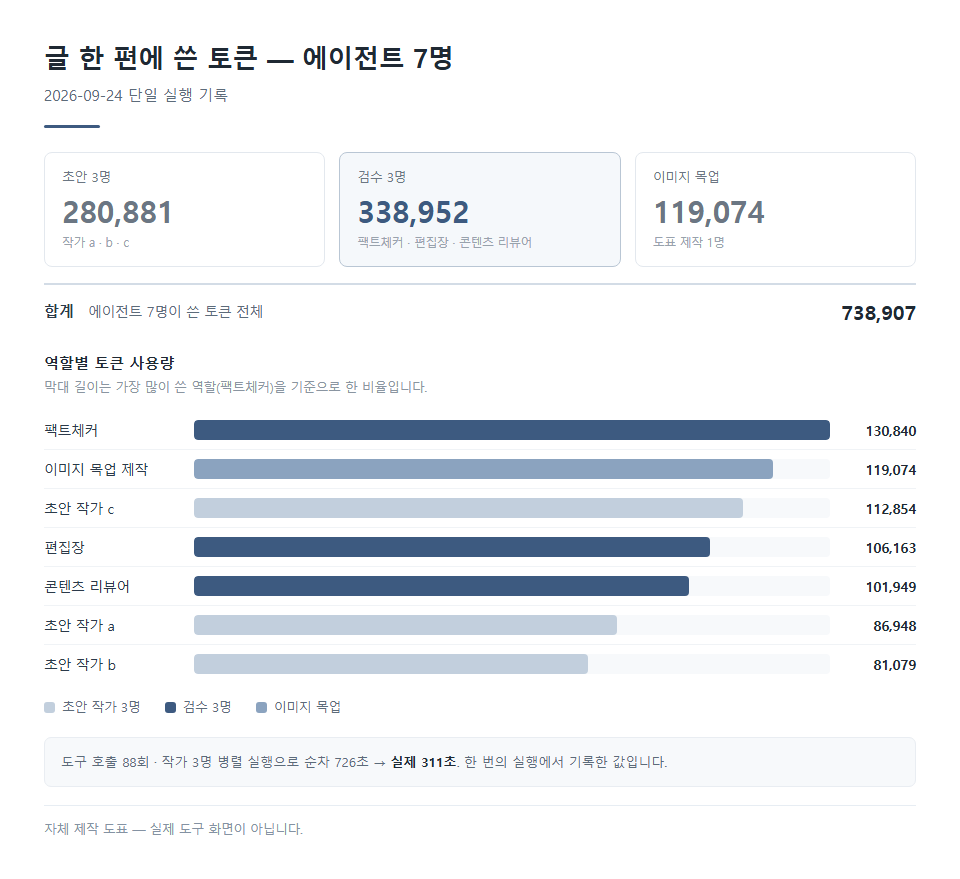
위 값은 각 에이전트가 작업을 마칠 때 반환한 실행 요약을 그대로 옮긴 것입니다. 표를 다 채우고 나서 가장 먼저 눈에 들어온 쪽은 팩트체커였습니다. 130,840개로 1위였고 도구 호출도 24회로 가장 많았습니다. 가장 적게 쓴 쪽은 초안 작가 b로 81,079개였습니다.
격차는 일의 성격에서 나왔습니다. 초안 작가는 전달받은 자료 안에서 문장을 만들면 되지만, 팩트체커는 수치 하나, 인용 하나마다 근거 파일과 공식 문서를 직접 열어 원문과 대조합니다. 확인할 항목이 늘수록 파일을 여는 횟수가 늘고, 열어서 읽은 내용이 그대로 토큰으로 쌓입니다. 콘텐츠 리뷰어는 도구 호출이 4회뿐인데도 101,949개를 소모했는데, 원고 전체를 한 번에 놓고 흐름을 판단하는 역할이기 때문으로 보입니다. 저는 도구 호출이 적으면 토큰도 적을 것이라고 짐작했는데, 이 항목에서 빗나갔습니다.
이 표를 읽을 때 전제 두 개를 밝혀 둡니다. 위 수치는 한 번의 실행에서 기록된 관찰값이며, 같은 작업을 다시 실행해도 같은 값이 나온다는 보장은 없습니다. 그리고 작업을 나눠 주고 결과를 합친 총괄 세션의 사용량은 이 합계에 포함되지 않았습니다.
토큰을 가장 많이 쓴 일은 글쓰기가 아니었습니다
| 묶음 | 사용 토큰 |
|---|---|
| 초안 3명 | 280,881 |
| 검수 3명 | 338,952 |
| 이미지 목업 제작 | 119,074 |
검수 쪽이 58,071개 더 많습니다. 저는 글쓰기가 가장 무거울 것이라고 예상했는데, 실제로는 이미 쓰인 글을 검증하는 일이 더 많은 자원을 썼습니다.
그래도 검수 단계를 줄일 생각은 없습니다. 그 한 편에서만 세 가지가 걸러졌기 때문입니다. 공식 문서에서 이미 폐기된 API 필드를 설명한 문장 1건, 근거보다 앞서 나간 단정 표현, 같은 내용을 반복한 중복 문단 3곳입니다. 특히 폐기된 필드는 독자가 그대로 따라 하면 값이 비거나 다른 결과가 나오는 오류입니다. 이 한 건만으로도 검수에 들어간 토큰은 제값을 했다고 판단합니다.
시간은 동시 실행으로 줄었습니다
| 구분 | 걸린 시간(초) |
|---|---|
| 작가 a·b·c 순차 합산 | 726 |
| 실제 소요(병렬) | 311 |
한 명씩 차례로 실행했다면 214초, 201초, 311초를 더해 726초가 필요했습니다. 동시에 실행하니 가장 오래 걸린 작가 c의 311초에 맞춰 세 명 모두 마무리됐습니다. 415초, 약 7분을 아낀 셈입니다. 다만 병렬 실행으로 줄어드는 것은 제가 기다리는 시간뿐이고, 토큰 소모량은 그대로입니다. 같은 엑셀 정리, 코덱스 198초 vs 클로드코드 131초에서 측정한 것이 도구별 속도였다면, 이번에 측정한 것은 일을 나누는 방식의 효과입니다.
나눠 맡길 일과 직접 할 일
7명에게 전부 맡긴 것은 아닙니다. 제가 쓰는 기준은 네 가지입니다.
첫째, 혼자 끝나고 결과를 눈으로 검증할 수 있는 일만 맡깁니다. 섹션 집필, 사실 대조, 이미지 제작이 여기에 해당합니다. 둘째, 한두 줄 수정과 판단이 필요한 통합은 제가 직접 합니다. 어미 하나를 바꿔 달라고 지시문을 쓰는 시간이, 세 파트를 직접 이어 붙인 시간보다 길었던 적이 있습니다. 설명 비용이 작업 비용을 넘어서는 지점부터는 맡기지 않습니다.
셋째, 같은 파일을 두 명이 수정하게 하지 않습니다. 초안을 맡은 세 명에게는 각자의 파일을 따로 줬고, 합치는 파일은 저만 수정했습니다. 그런데도 통합 과정에서 중복 문단이 생겼습니다. 파일을 나눠도 내용은 겹칩니다. 넷째, 검수는 작성한 쪽과 다른 쪽에 배정합니다. 작성한 사람은 자기 문장을 다시 읽어도 같은 자리에서 같은 판단을 반복합니다. 스킬 60개 삭제해도 0.1k, 클로드코드 토큰 실측 6가지를 쓸 때도 제 측정값의 오류는 다른 쪽에서 나왔습니다.
이 방식의 비용은 토큰이 아니라 한도입니다
한 편에 74만 토큰을 쓰면 같은 한도 구간 안에서 처리할 수 있는 다른 작업이 그만큼 줄어듭니다.
그래도 한 편에 이 정도가 들어간다는 것을 확인하면서, 이미 주 2편으로 정해 둔 상한을 유지하는 판단에 이 기록이 근거가 됐습니다. 검수에 배정하는 몫을 줄이지 않으려면 편 수를 늘릴 수 없고, 오류가 검수에서 나온 이번 기록을 보면 먼저 줄일 곳은 검수가 아닙니다.
같은 방식을 시도하신다면 순서를 이렇게 잡으시기 바랍니다. 역할을 나누기 전에 담당별 완료 조건을 문장으로 적어 두십시오. 그리고 실행할 때마다 사용량을 기록해 두십시오. 저는 에이전트가 작업을 마칠 때 반환하는 실행 요약(토큰·소요 시간·도구 호출 수)을 역할별로 옮겨 적는 방식으로 위 수치를 모았습니다. 기록이 없으면 다음에 늘릴지 줄일지 판단할 근거가 남지 않습니다.