블로그 글 1773번은 2026년 10월 2일 업무일지에 예약 검증 통과로 남았는데, 같은 일지에 사이트를 다시 조회하지 않았다는 문장도 있었습니다. 이 기록을 새 대화에 “작업 끝남”으로만 넘기면 다음 대화가 공개 화면 확인을 건너뛸 수 있습니다. 챗GPT에서 새 대화를 열기 전에 한 일, 확인한 것, 남은 일을 세 줄로 나눠 적는 방법을 이 기록으로 설명합니다.
이 블로그 작업은 챗GPT 웹이 아니라 여러 AI 에이전트 도구로 진행했습니다. 아래 사례는 당시 업무일지를 읽고, 그 내용을 챗GPT 새 대화에 넘긴다고 가정해 다시 쓴 예시입니다. 세 줄 양식은 원본 영상 「챗GPT 새 대화 열기 전」에서 가져왔습니다.
예약 검증을 마친 날의 기록에는 공개 확인이 없었습니다
AI 여러 명에게 글 한 편을 맡긴 작업처럼 단계가 많은 일은 단계마다 끝나는 지점이 다릅니다. 1773번 글 「인물 사진 7장, 첨부한 3장만 옷 색이 같았습니다」는 10월 2일에 검수를 통과했고, 서버에 저장된 본문이 로컬 파일 및 보존 원고와 같다는 대조도 끝났습니다. 발행은 10월 9일 오전 9시로 예약된 상태였습니다.
그날 업무일지는 두 가지를 갈라 적었습니다. 예약 검증은 통과했고, 일지를 쓰는 동안에는 사이트를 다시 조회하지 않았으므로 상태가 바뀌었는지는 확인하지 않았다는 내용입니다. 10월 2일 일지에는 10월 9일 이후의 공개 전환, 본문 이미지, 사이트맵, 관련 글 카드 점검이 미완료로 남아 있었습니다.
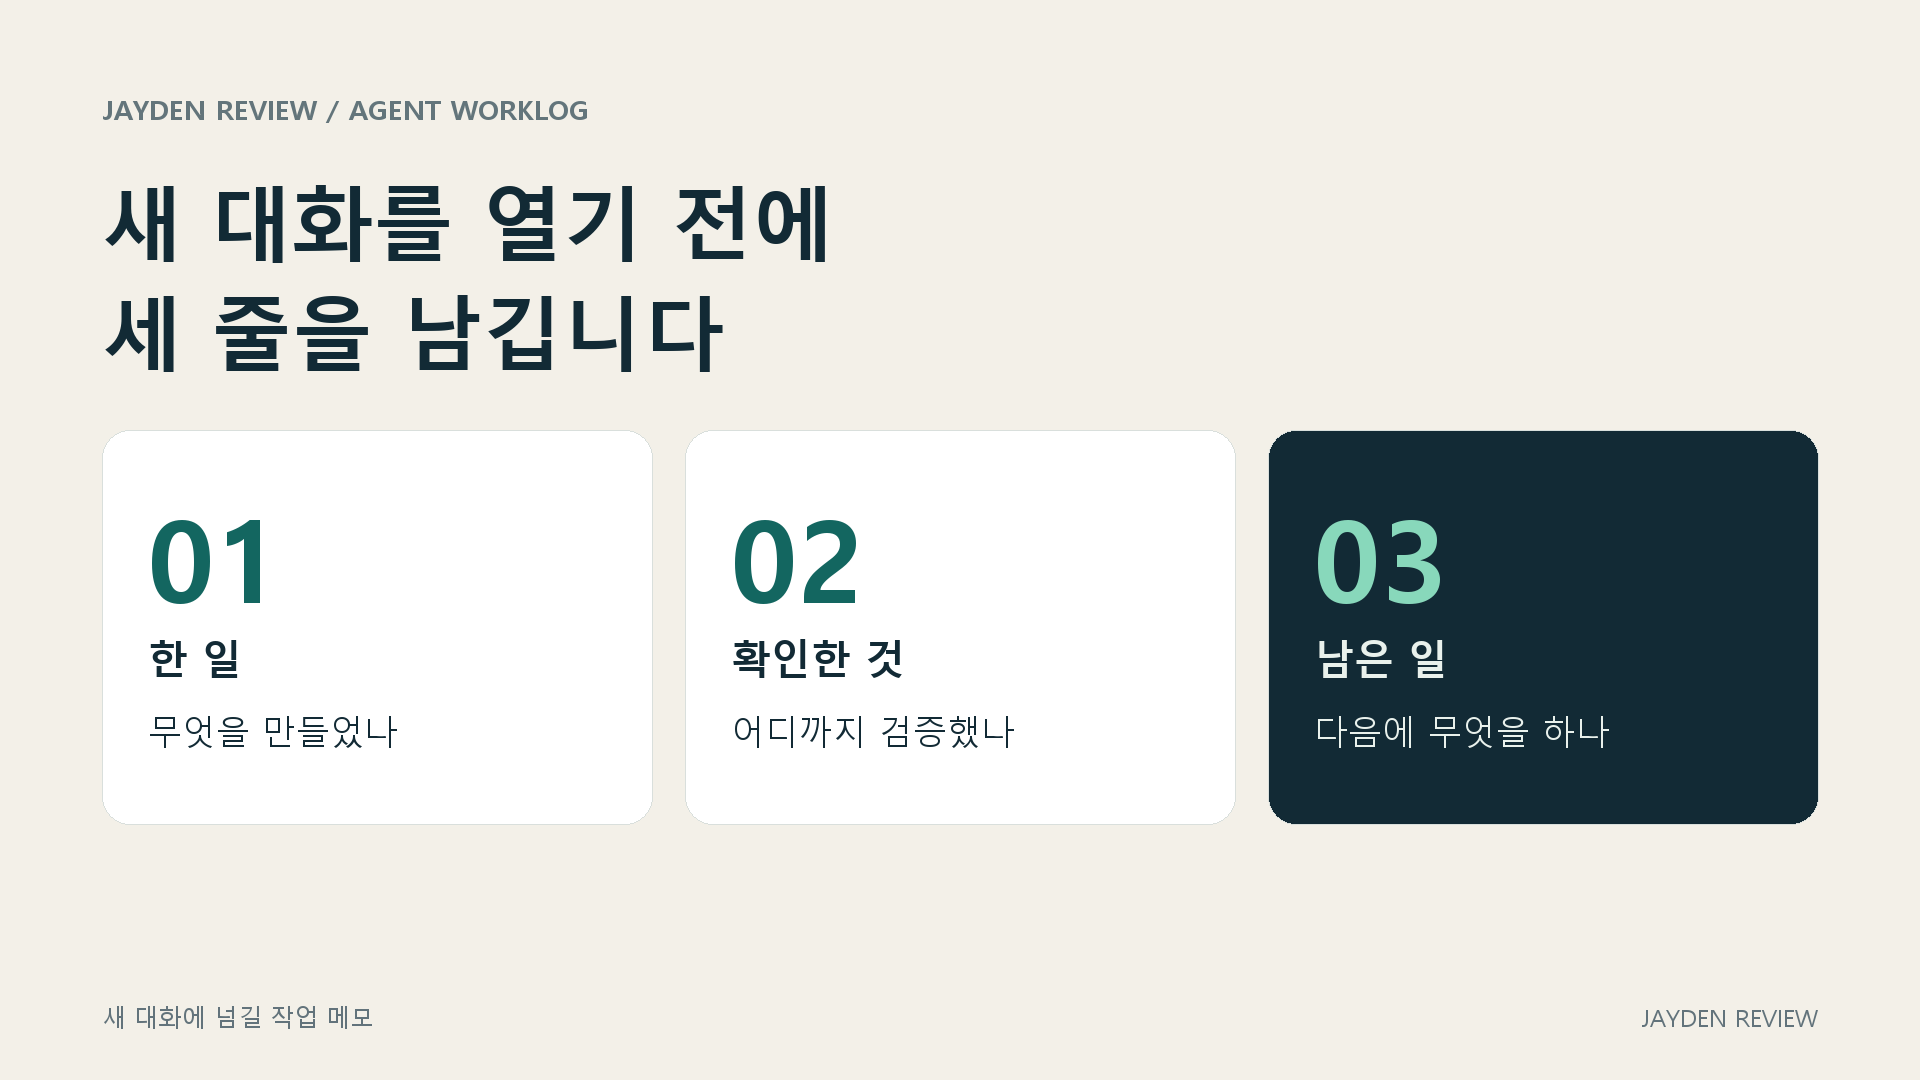
같은 기록을 세 줄로 나누면 이렇게 됩니다
복사해서 쓸 양식은 아래와 같습니다. 대화를 끝내기 전에 채우고, 다음 대화의 첫 메시지에 붙입니다.
한 일: [결과물 이름·최신 파일·완료한 범위]
확인한 것: [확인한 날짜·수치나 상태·근거 문서 또는 링크]
남은 일: [아직 확인하지 못한 것·다음에 할 일]
10월 2일 일지를 이 양식에 옮기면 다음과 같습니다.
한 일: 이미지 실험 글 1773을 통합하고 10월 9일 오전 9시 예약 내용을 검증했습니다.
확인한 것: 10월 2일 업무일지에 서버 본문·보존 원고 일치와 이미지 검수 통과가 기록돼 있습니다. 당시 상태는 예약입니다.
남은 일: 10월 9일 이후 공개 전환·본문 이미지·사이트맵·관련 글 카드가 정상인지 확인해야 합니다.
‘한 일’에는 발행이 아니라 예약 내용 검증이라고 적었고, 공개 화면 점검은 ‘남은 일’로 넘어갔습니다. 이 메모만 읽은 새 대화는 어디서부터 시작해야 하는지 알 수 있습니다.
10월 18일 조회 결과를 더하면 세 줄이 이렇게 바뀝니다
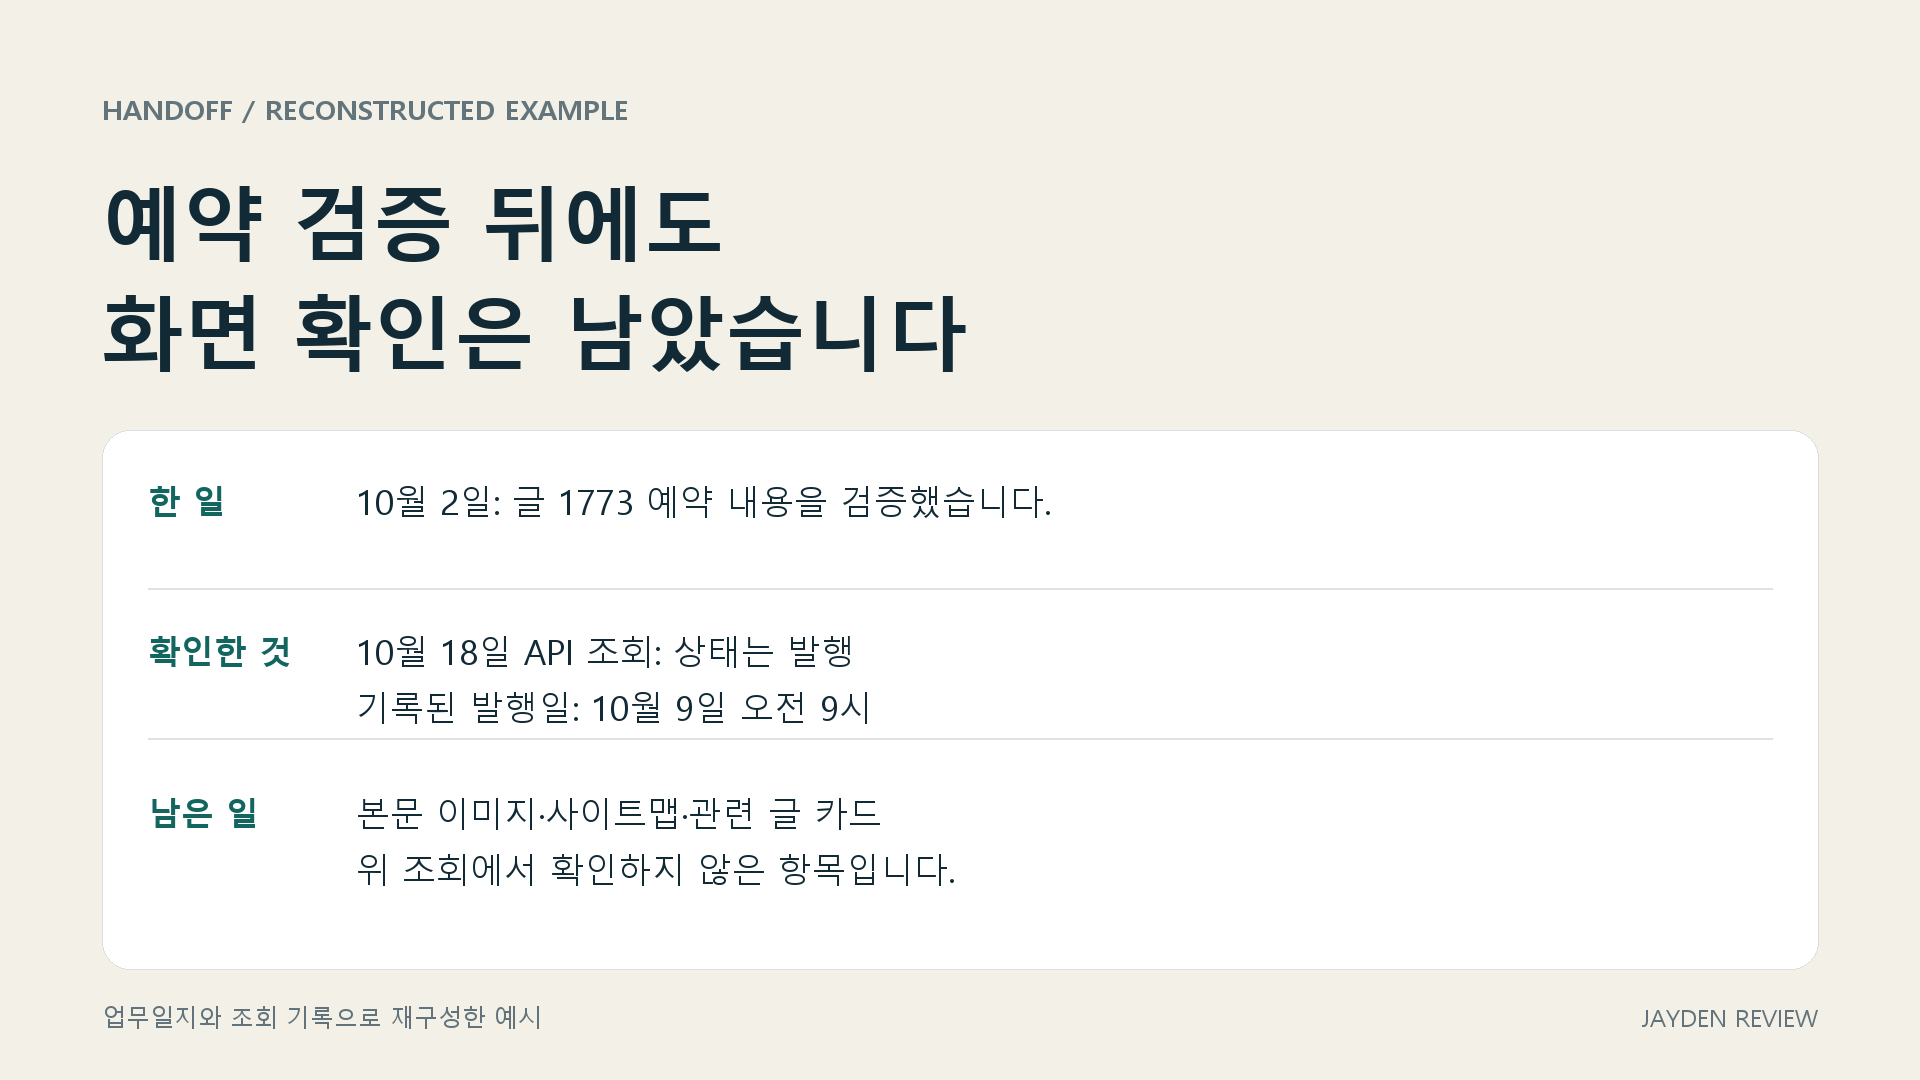
10월 18일에 1773번 글을 공개 API로 조회하자 상태는 발행, 발행 시각은 2026년 10월 9일 오전 9시로 나왔습니다. 이 조회를 반영해 메모를 고치면 다음과 같습니다.
한 일: 이미지 실험 글 1773의 예약 내용을 10월 2일에 검증했습니다.
확인한 것: 10월 18일 공개 API 조회에서 상태는 발행, 발행 시각은 10월 9일 오전 9시입니다.
남은 일: 본문 이미지·사이트맵·관련 글 카드는 이 조회에 포함되지 않아 화면에서 확인해야 합니다.
이 조회는 글의 공개 상태만 본 것입니다. 날짜가 붙은 기록이므로 읽는 시점의 상태를 대신하지 못하고, 다음 대화가 이 메모를 쓸 때는 날짜부터 확인하고 필요하면 다시 조회해야 합니다.
새 대화에는 메모를 직접 붙이거나 파일로 올립니다
챗GPT 프로젝트는 관련 대화와 파일, 지침, 출처를 함께 두는 공간입니다. 공식 문서는 같은 자료로 오래 작업하거나 결과물이 여러 개 나올 때 프로젝트를 만들고, 그 안에서 새 대화를 시작해 공유 파일과 지침을 쓰도록 안내합니다. 주간 보고서라면 공통 작성 지침과 참고 자료는 프로젝트에 두고, 이번 주 보고서는 별도 대화에서 작성할 수 있습니다.
메모리는 이전 작업의 유용한 맥락을 이후 작업으로 가져오는 기능입니다. 웹 챗GPT 메모리와 로컬 코덱스 메모리는 저장소와 제어 방식이 다릅니다. 여기서는 웹 챗GPT를 기준으로 하며, 메모리는 개인 맞춤 설정에서 관리합니다. 사용할 수 있는 설정은 계정과 작업공간에 따라 확인해야 합니다.
프로젝트에 파일이 있어도 이번에 어디까지 끝냈는지는 메모에 적어 둡니다. 검토 전 초안과 검토를 마친 초안이 함께 있다면, 최신 파일 이름과 검토한 범위를 지정해 주는 편이 분명합니다.
메모는 프로젝트 자료나 정해 둔 업무 문서 한 곳에 보관합니다. 새 대화에서는 최신 메모를 붙여 넣거나, 메모 파일을 프로젝트에 업로드한 뒤 “먼저 근거를 읽고 남은 일부터 진행해 주세요”라고 요청합니다. PC의 파일 경로만 적는다고 웹 챗GPT가 그 파일을 읽는 것은 아닙니다. 같은 이름의 메모를 여러 곳에 복사했다면 날짜를 확인해 최신본을 골라야 합니다.
AI가 정리한 요약은 ‘완료’부터 근거와 맞춥니다
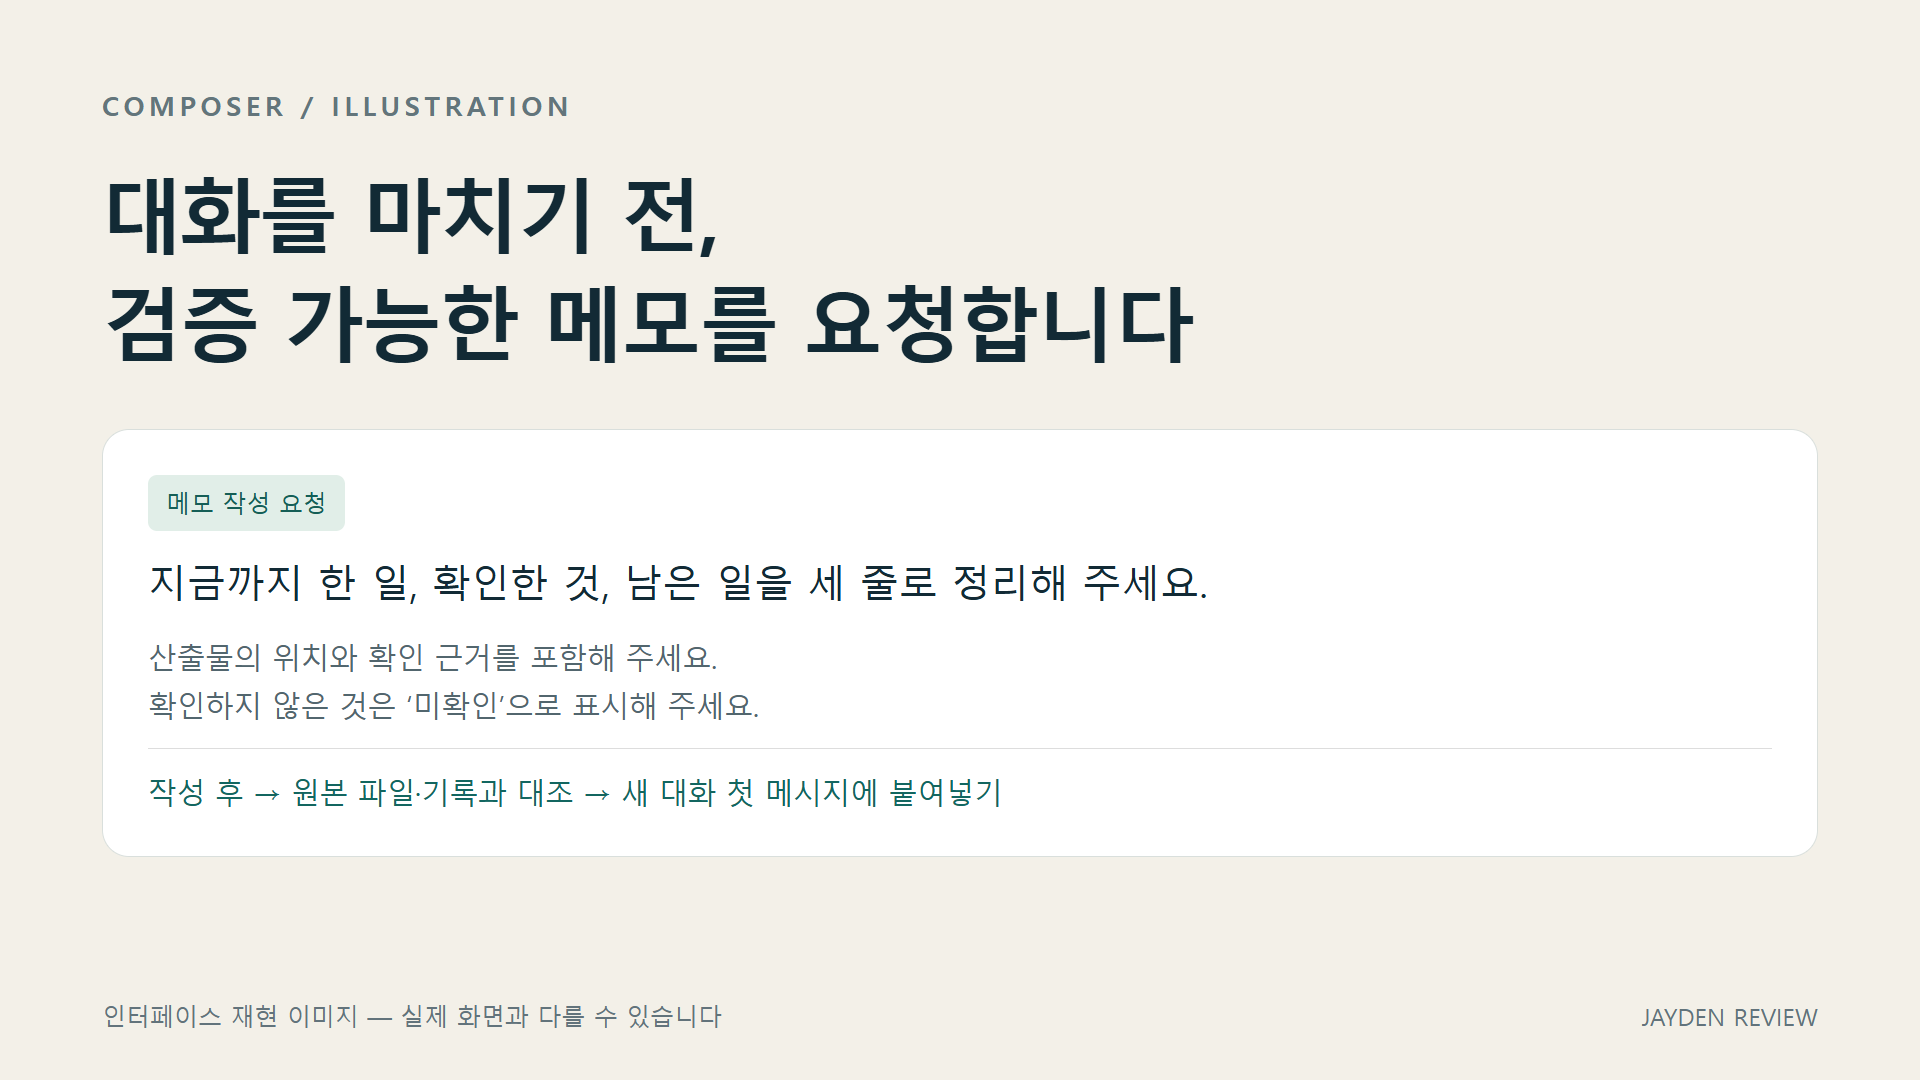
챗GPT에 정리를 맡길 때는 “지금까지 한 일, 확인한 것, 남은 일을 세 줄로 정리해 주세요. 확인 근거가 없는 항목은 남은 일에 넣어 주세요”라고 요청합니다. 받은 답은 붙이기 전에 파일 이름과 확인 범위를 고칩니다.
요약에서 먼저 볼 단어는 ‘완료’입니다. 보고서를 작성했다는 말에는 숫자 대조나 상사 검토가 들어 있지 않을 수 있습니다. ‘보고서 작성 완료’를 ‘초안 저장, 숫자 대조는 미완료’로 고치면 다음 작업이 분명해집니다. 확인한 숫자 옆에는 원문 위치와 기준일을 붙입니다. AI가 출처를 적었더라도 링크를 열어 그 문장이나 표에 값이 실제로 있는지 봐야 하고, 접속되지 않거나 값이 다르면 미확인으로 돌립니다.
블로그 기록에도 같은 구분이 여러 번 나왔습니다. 같은 글을 세 모델로 검수한 기록처럼 검수 결과를 비교할 때 ‘검수 통과’와 ‘최종 파일에 수정 반영’은 각각 근거가 필요합니다. 검색 색인 요청도 요청이 접수된 것과 실제 색인이 끝난 것을 구분해 기록했습니다.