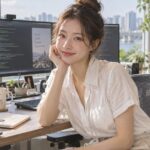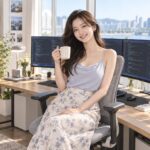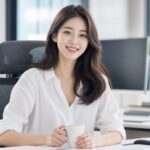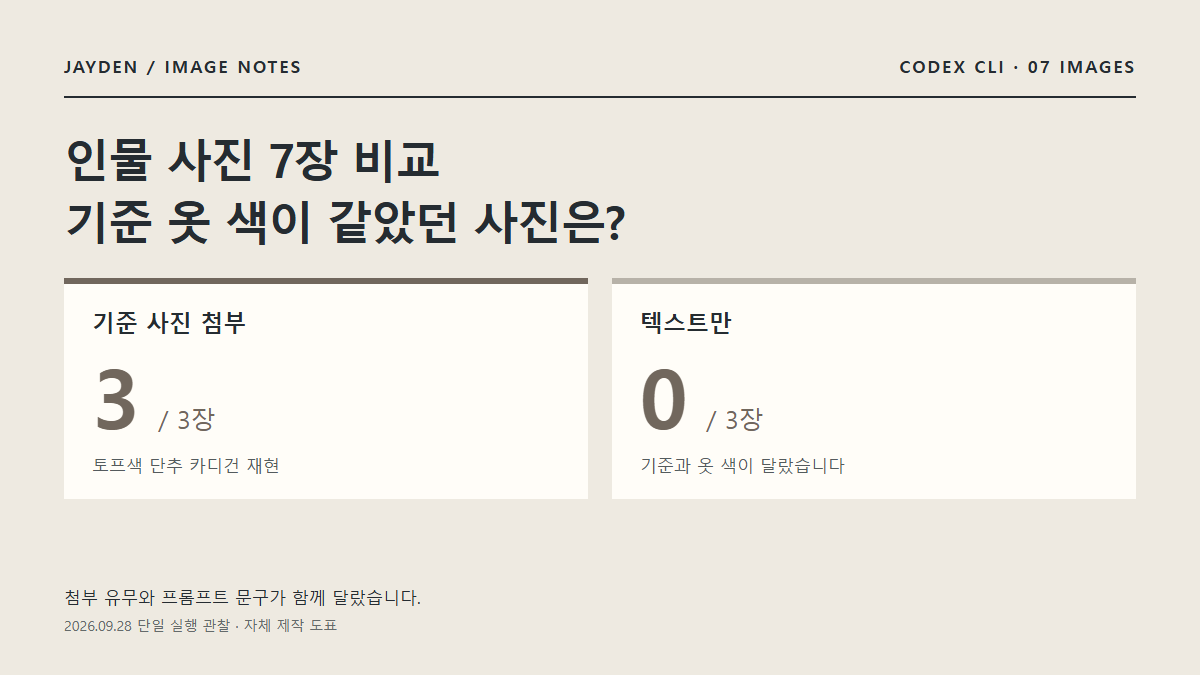
AI 인물 사진 7장을 만들어 비교하니, 기준 사진을 첨부한 3장만 옷 색이 같았습니다. 같은 인물을 다시 만들 때 어떤 자료를 함께 줄지 확인해 본 기록입니다.
기준 사진을 첨부해서 만든 3장과, 글로만 인물을 묘사해서 만든 3장을 같은 날 직접 만들어 비교했습니다. 결과는 옷 색을 그대로 재현한 비율이 3대 0으로 갈렸고, 두 개의 AI에게 블라인드로 채점을 맡긴 얼굴 유사도 점수도 첨부 쪽이 더 높게 나왔습니다.
Codex CLI로 사진 7장을 만드는 동안 유료 API 호출은 0회였습니다. 생성 전후 주간 사용량 표시는 35%에서 38%로 3퍼센트포인트 올랐습니다. 이를 이미지 한 장의 고정 비용으로 볼 수는 없습니다.
예전에 코덱스와 클로드코드의 작업 속도를 비교한 글에서도 코덱스를 다른 작업에 써 본 적이 있는데, 이번에는 같은 도구로 인물 사진을 만들어봤습니다.
AI 인물 사진, 같은 얼굴을 유지하려면
이 블로그는 글 한 편에 여성 인물 사진을 한 장씩 넣습니다. 문제는 글마다 인물을 새로 생성하다 보니 얼굴이 매번 달라져서, 같은 블로그의 인물이라는 느낌이 없었다는 점입니다.
제가 사용하는 이미지 생성 도구는 ChatGPT 구독 계정으로 로그인한 Codex CLI를 호출하는 방식입니다. 기존 사진을 기준으로 주면 -i 옵션으로 해당 파일을 첨부해서 실행합니다. 관련 옵션은 Codex CLI 공식 문서에서 확인할 수 있습니다.
이번에 확인하고 싶었던 것은 하나였습니다. 기준 사진을 첨부하면 정말 같은 인물이 유지되는지, 글로 묘사하는 방식과 결과가 얼마나 다른지였습니다.
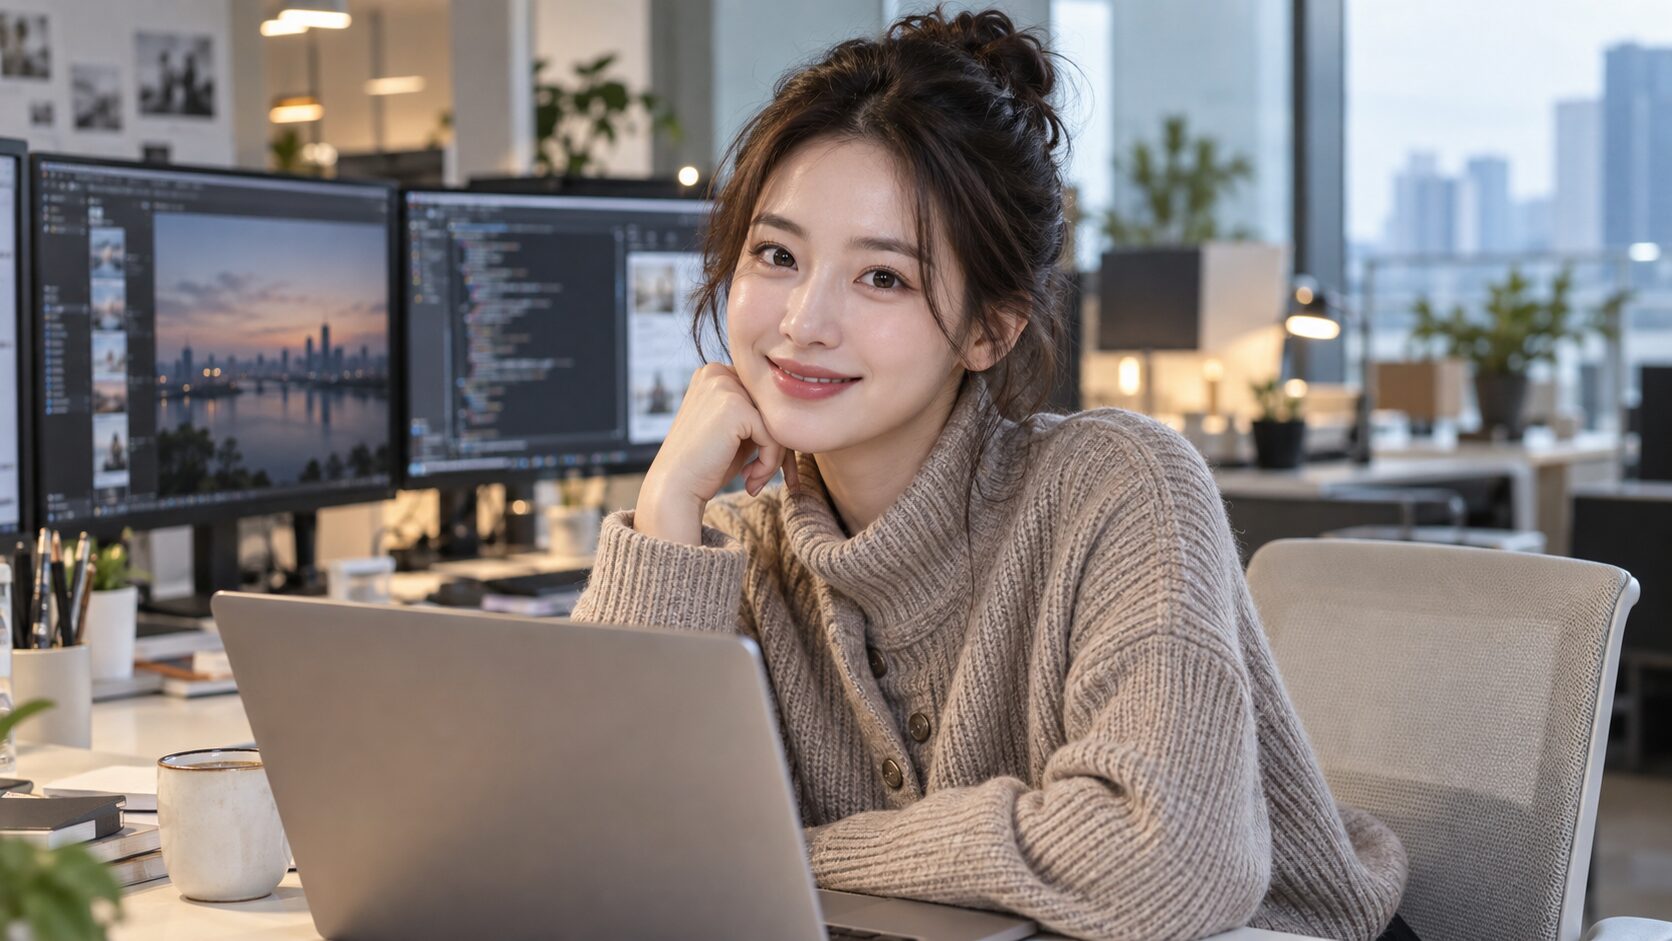
실험은 이렇게 설계했습니다. 사무실 책상 앞에서 올림머리를 한 기준 사진 1장을 먼저 만들었습니다. 같은 카페 장면에서 텍스트만 준 사진 3장, 기준 사진 파일을 첨부한 사진 3장을 같은 날 순서대로 생성했습니다.
두 조건은 사진 첨부 여부와 프롬프트 문구가 함께 달랐습니다. 텍스트만 준 쪽은 인물 묘사 문장 전체를 그대로 넣었고, 사진을 첨부한 쪽은 “레퍼런스와 같은 여성, 같은 얼굴과 머리, 옷”이라는 짧은 문구만 넣었습니다. 하루 동안 한 번 실행한 관찰이며, 사진 첨부의 효과만 분리해서 확인한 실험은 아닙니다.
실행하면서 막힌 세 가지
일곱 장을 만드는 동안 예상하지 못한 일이 세 가지 있었습니다. 순서대로 정리합니다.
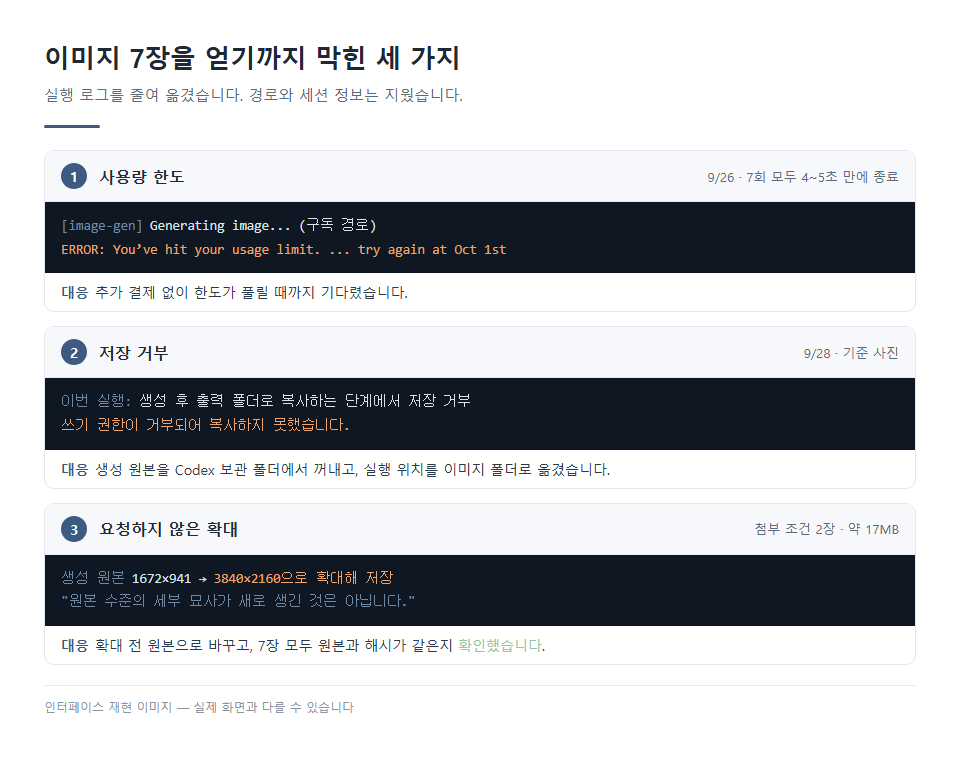
① 사용량 한도로 7회 전부 실패했습니다. 9월 26일 첫 시도에서는 일곱 번 모두 4~5초 만에 “사용량 한도, 10월 1일에 다시 시도하라”는 오류가 떴습니다. 구독 사용량 한도에 걸린 것입니다. 추가 결제 대신 해제를 기다렸는데, 실제로는 10월 1일 안내보다 앞선 9월 28일에는 사용할 수 있었습니다. 왜 더 빨리 풀렸는지는 확인하지 못했습니다. 이번에는 재시도로 실제 사용 가능 여부를 확인했습니다.
② 이미지가 생성됐는데 저장이 거부됐습니다. 기준 사진을 만들 때 실행 위치가 작업용 임시 폴더였는데, 이번 실행 로그에는 출력 폴더로 복사할 때 쓰기가 거부됐다고 기록됐습니다. 로그에는 “쓰기 권한이 거부되어 복사하지 못했습니다”라고 남았습니다. 생성된 원본 파일은 도구 자체의 보관 폴더에 남아 있어서 그것을 회수했고, 이후에는 실행 위치를 이미지 폴더 안으로 옮겨 나머지 여섯 장은 정상적으로 저장됐습니다. 클로드코드 훅 가드가 지난 30일 동안 작업을 39번 막았던 기록을 정리한 적이 있는데, 이번에도 생성 성공과 저장 성공을 따로 확인해야 했습니다. 저는 이후 실행 위치와 출력 폴더를 먼저 확인했습니다.
③ 생성 원본 대신 확대본 두 장이 저장됐습니다. 첨부 조건에서 만든 사진 두 장이 3840×2160 크기로 저장됐는데, 파일 용량이 약 17메가바이트로 다른 장보다 약 8배 컸습니다. 로그에서 Codex는 “4K photo” 요청에 맞추려고 생성 원본(1672×941)을 별도 이미지 처리로 확대했다고 설명했습니다. 같은 문구가 있던 텍스트 조건은 확대되지 않았으므로, 문구가 확대를 유발한다고 일반화할 수는 없습니다. 도구 스스로도 “원본 수준의 세부 묘사가 새로 생긴 것은 아닙니다”라고 남겼습니다. 비교의 공정성을 위해 확대 전 원본으로 교체했고, 교체 후 일곱 장 모두 파일 해시값이 도구가 생성한 원본과 일치하는 것을 확인했습니다. 프롬프트에 해상도 문구를 넣으셨다면, 실제 파일 크기와 해상도를 확인해서 후처리로 부풀려진 것은 아닌지 짚어보시길 권합니다.
블라인드 채점 결과
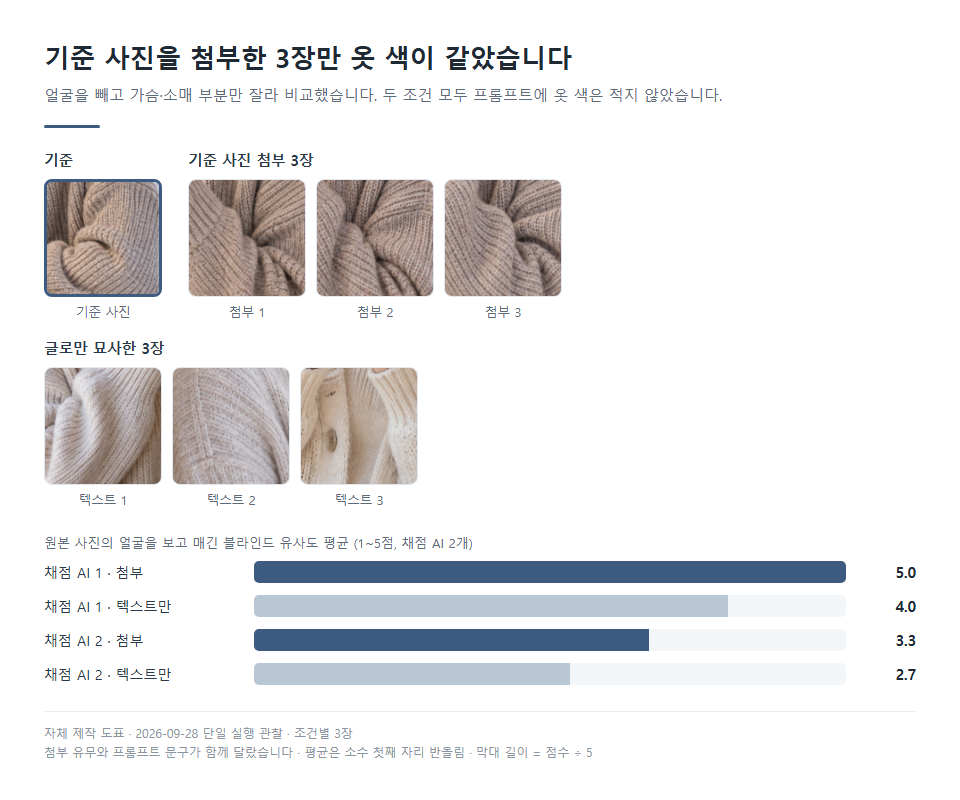
일곱 장 중 여섯 장(조건별 3장씩)을 무작위 이름으로 바꿔 채점 AI 두 개에 각각 보여줬습니다. 어느 조건인지는 알려주지 않았고, 채점이 끝난 뒤에야 정답을 열었습니다. 채점 기준은 기준 사진과의 얼굴 유사도 1~5점(5점이 확실히 동일 인물)입니다. 채점자는 모델 자동 선택기가 골랐는데, 1차는 GPT-6 Luna, 2차는 다른 회사 모델 조건으로 Sonnet 5가 뽑혔습니다.
| 조건 | 파일 | 채점자1 GPT-6 Luna | 채점자2 Sonnet 5 |
|---|---|---|---|
| 첨부 | ref-1 | 5 | 3 |
| 첨부 | ref-2 | 5 | 4 |
| 첨부 | ref-3 | 5 | 3 |
| 텍스트만 | noref-1 | 4 | 2 |
| 텍스트만 | noref-2 | 4 | 4 |
| 텍스트만 | noref-3 | 4 | 2 |
| 평균 | 첨부 / 텍스트만 | 5.0 / 4.0 | 3.3 / 2.7 |
두 채점자 모두 첨부 조건의 평균이 더 높았습니다. 1차는 1.0점, 2차는 약 0.67점 차이였습니다(평균 표시는 소수 첫째 자리 반올림). 다만 점수를 주는 후함의 정도는 채점자마다 크게 달랐고, 개별 순위도 완전히 일치하지는 않았습니다. 2차 채점자는 텍스트만 조건인 noref-2에도 4점을 줘서 첨부 조건의 최고점과 같았습니다.
제가 원본을 열어 비교한 옷 색에서도 차이가 있었습니다. 기준 사진의 토프색 단추 카디건을 색과 짜임까지 재현한 것은 첨부 조건 3장 전부였고, 텍스트만 조건은 3장 중 한 장도 재현하지 못했습니다(밝은 오트밀색 단추 카디건 한 장, 단추가 안 보이는 베이지 터틀넥 한 장, 아이보리색 단추 카디건 한 장). 올림머리는 여섯 장 모두 유지됐습니다. 옷 색은 두 조건 프롬프트 어디에도 지정하지 않은 부분이라 더 눈에 띄었습니다.
채점자2의 설명에서는 관찰 오류도 발견했습니다. ref-2를 설명하면서 “손이 노트북에 가려 보이지 않는다”고 적었는데, 정작 해당 사진에는 노트북 자체가 없었습니다. ref-1의 의상도 “부분 일치”로 판정했지만, 제가 직접 사진을 열어 확인해 보니 기준 사진과 똑같은 단추 카디건이었습니다.
이전에 모델마다 검수 결과가 0건, 1건, 5건으로 갈렸던 사례에서도 확인했듯, 점수와 지적의 근거를 원본과 대조하는 절차가 필요했습니다. 이번에도 점수만 받아 적었다면 노트북이 없다는 사실을 놓쳤을 것입니다.
한계와 적용
하루 동안 조건별로 3장씩 만든 관찰이고 프롬프트 차이도 있어, 이번 결과를 일반적인 효과로 확대하기는 어렵습니다. 레퍼런스 사진이 실제로 이미지 모델 입력에 들어갔는지는 Codex의 자체 보고로만 확인했습니다. 호출 내용을 직접 열어 본 것은 아닙니다.
그래도 옷 색 재현이 첨부 3장에서는 3장 모두, 텍스트만 조건에서는 0장이었다는 차이는 제 눈으로 직접 확인한 부분입니다. 그래서 앞으로는 같은 인물을 다시 쓸 일이 있으면 기준 사진을 첨부하는 방식을 먼저 시도해 볼 계획입니다.
저장 실패를 겪었던 경험을 감안해, 실행할 때는 처음부터 이미지 폴더 안에서 명령을 실행할 계획입니다. 그리고 확대 저장이 반갑지 않다면 프롬프트에 “4K photo” 같은 해상도 문구를 아예 넣지 않는 방법도 시험해 볼 생각입니다. 다만 이 부분은 아직 시도해 보지 않은 계획일 뿐, 실제로 확대를 막아 주는지는 다음에 직접 실행해 봐야 알 수 있습니다.